Bir sistemin yaptığı seçimlerden sonra aldığı puanlarla davranışını değiştirmesi, pekiştirmeli öğrenme nedir sorusunun kısa cevabıdır. Sistem bir ortamda eylem seçer, sonucunu görür ve ödül sinyali alır. Eğitimde amaç, zaman içindeki toplam ödülü artıran bir davranış öğrenmektir.
Ödül burada sayısal geri bildirimdir. Sistemin sevinmesi, ne istediğimizi anlaması veya doğru davranacağına söz vermesi anlamına gelmez. Bu ayrımı görmek için hayalî bir bilye oyunu yeterli. Oyunda yüksek puan toplamakla bilyeyi istediğimiz kaba ulaştırmak her zaman aynı sonuç olmayabilir.
Eylem, ortam ve ödül ne demek?
AWS'nin Türkçe açıklamasında aracı, ortam içinde eylem seçen sistem olarak tanımlanır. Durum, o anda karşılaştığı koşullardır. Eylem yeni bir duruma yol açar; ödül ise bu geçişle ilgili sayısal geri bildirimi verir. Hangi durumda hangi eylemin seçileceğini belirleyen davranış kuralına politika denir.
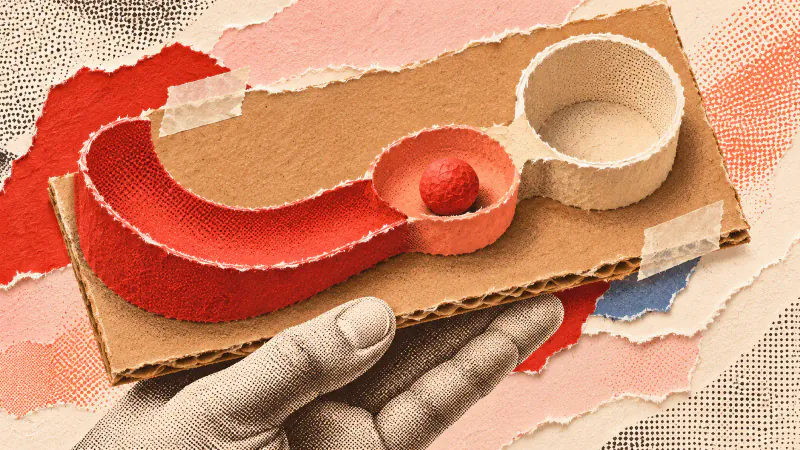
Bilye örneğini bilgisayarda kurulmuş bir oyun olarak düşünelim. Gerçek bir deneyden veya uygulamanın özelliğinden söz etmiyoruz. Ekrandaki kırmızı bilye bir çatala geliyor. Aracı, küçük kapağı sağa ya da sola açabiliyor. Bilyenin konumu durumun bir parçası; kapağı açmak eylem. Yola devam eden bilye de oyunun yeni durumunu oluşturuyor.
Tasarımcı, bilye derin hedef kabına girince on puan verilsin diyebilir. Aracıya her çatala geldiğinde doğru kapağı gösteren bir cevap anahtarı vermedik. Denemelerin sonuçlarından hangi seçimlerin puan getirdiğini öğrenmesini istiyoruz. Puanlar ve oyun kuralları bu örnek için bizim koyduğumuz koşullar.
Bir turdaki seçimle eğitim boyunca öğrenilen davranışı da ayırırız. Deneme kaydına başlangıç konumunu ve açılan kapağı yazmak, sonraki turu öncekine bakarak değerlendirmeyi sağlar. Başlangıç değişmişse iki sonucu aynı koşulda alınmış gibi karşılaştırmayız.
İlk kazanç, en iyi yol olmayabilir
Oyunun ilk sürümünde sol yol kısa olsun ama bilye çoğu denemede kenardan düşsün. Sağ yol daha uzun sürsün ve sonunda hedef kabına ulaşabilsin. Yalnızca ilk kapağın hemen sonrasına bakmak, sağdaki yolun sonucunu kaçırır. Denemeyi bilye durana kadar izlemek gerekir.
Aynı başlangıçtan bir kez sağa gitmek, o yolun her koşulda başarılı olduğunu kanıtlamaz. Hayalî oyunumuzda başlangıç konumunu biraz değiştirip yeniden deneyebiliriz. Bilye çatala başka açıyla geldiğinde önceki seçim işe yaramayabilir. Böyle bir denemede puanı ve bilyenin sonunda nerede kaldığını birlikte kaydederiz.
Öğrenen sistem, bildiği kazançlı seçeneği kullanmakla başka seçenekleri araştırmak arasında da denge kurar. Buna keşif ve yararlanma dengesi denir. Oyunumuzda hep ilk puan alınan kapağı seçmek, diğer yolun daha iyi sonuç verebildiğini görmeyi engelleyebilir. Her tur rastgele kapak açmak ise öğrenilmiş bir seçimi kullanmaya fırsat bırakmaz.
Yanlış yere puan verirsek ne olur?
Şimdi oyunun tasarımını değiştirelim. Derin hedef kabından önce küçük ve sığ bir toplama kabı olsun. Geliştirici, hedefe yaklaşmayı ödüllendirmek isterken bilye bu küçük kaba her girdiğinde on puan yazsın. Bu kap bilyeyi tutuyorsa aracı yüksek puan alabilir, fakat derin kap boş kalır.
Ortada yalnızca kötü oynayan bir sistem yok. Bizim verdiğimiz puan, ulaşmak istediğimiz sonucu yanlış temsil ediyor. Microsoft'un makine öğrenmesi hata açıklaması, tanımlanan ödülle gerçek amaç arasındaki uyumsuzluğun istenmeyen davranış doğurabileceğini anlatıyor. Sistemin puanı yükseldi diye hedefimizin karşılandığını varsayamayız.
Hayalî oyunu düzeltirken önce başarı koşulunu açık yazarız: Bilye derin kabın içinde durmalı. Sonra puanın gerçekten bu olayda verildiğini kontrol ederiz. Küçük kaba düşme ve parkurdan çıkma durumlarını ayrıca deneriz. Yalnızca ödül kuralını değiştirmekle yetinmeyip ortaya çıkan oyunu izleriz; bilye yine yanlış yerde kalıyorsa sonuç hâlâ istediğimiz gibi değildir.
Her yapay zekâ ajanı böyle mi öğrenir?
Yapay zekâ ajanları yazısındaki araçla işlem yapan sistem, hedefe göre sonraki adımı seçer. Bu kullanım biçimi, o sistemin mutlaka pekiştirmeli öğrenmeyle eğitildiğini göstermez. Bir sistemin çalışırken karar vermesiyle eğitimde davranışının nasıl değiştiği ayrı sorulardır.
Benzer biçimde, ince ayar önceden eğitilmiş modeli ek eğitimle uyarlamayı anlatır. Örnek cevaplarla eğitim ve ödülle yönlendirilen eğitim farklı düzenlerde kurulabilir. Kullanıcı ekrandaki akıcı metinden hangi yöntemin kullanıldığını çıkaramaz.
Bir açıklamayı Yapay Zeka'ya Türkçe sorup altındaki kaynakları açabilirsiniz. Bilye örneğindeki terimleri kendi cümlelerinizle anlatmayı deneyin. Yanıtta yalnızca "puan yükseldi" deniyorsa soruyu daraltın: "Bilyenin derin kaba ulaştığını hangi kayıt gösteriyor?" Gelen kaynakta bu ayrımın gerçekten açıklanıp açıklanmadığına bakın.